domenica 26 ottobre 2014

Applicare la TOC - teoria dei constraints - in un ambito di produzione - episodio 1

Pezzullo un po' vintage, perchè scritto quasi vent'anni fa, ma che è ancora attuale.


In questo documento vengono trattati due elementi fondamentali e costitutivi di ogni pratica gestionale di successo in ambito produttivo. La necessità di determinare quali siano i fattori di successo nella conduzione di un impianto o di una fabbrica ha fatto sì che ogni anno venisse prodotta una mole considerevole di studi sulle migliori pratiche di management. 

In questo documento per prima cosa verrà mostrato quale approccio alla produzione è stato sviluppato dalla TOC (teoria dei constraint) e quali risultati ha prodotto. 

In secondo luogo si discuterà delle barriere che si oppongono al cambiamento in ambito produttivo e di come la TOC può essere utilizzata per superarle.


L'approccio TOC alla produzione va sotto il nome di Drum-Buffer-Rope (da qui in avanti si userà l'acronimo DBR), che è stato ampiamente descritto nei libri del dr. Goldratt L'obiettivo (The Goal nell'edizione originale), The Race e The Haystack Syndrome; a questi libri si rimanda per un ulteriore approfondimento dell'argomento.

Con l'aiuto di uno schema semplificato di impianto produttivo vedremo rapidamente nel seguito in che cosa consiste il DBR.


L'impianto "pilota" è molto semplice: ci sono 5 stazioni di lavoro (risorse) che in sequenza processano la materia prima che viene rilasciata all'inizio della catena, e la passano alla stazione seguente fino ad avere il prodotto finito. Nella realtà la catena non finisce qui ma continua fino al cliente finale, per il momento limitiamoci ad un ambito strettamente di produzione e quindi ipotizziamo che la catena termini con la produzione del prodotto finito.


Le consuete pratiche di gestione della produzione prevedono di rilasciare la materia prima, magari a lotti, di processarla tutta nella prima stazione e al termine del lotto di produzione di passarla alla stazione successiva, e così via fino ad ottenere il prodotto finito. Il tasso con il quale viene rilasciata la materia prima viene spesse volte influenzato da un certo numero di fattori quali la necessità di tenere occupate le stazioni di lavoro (cioè gli impianti), la domanda complessiva di prodotto finito, la dimensione degli ordini e altri fattori ancora. Ci sono però due elementi dai quali non si può prescindere quando si stabilisce il tasso di rilascio (ovvero la politica di rilascio) di materia prima: quello che chiede il mercato (la cosiddetta domanda) e le misure che sono correntemente utilizzate nell'impianto. Uno degli assunti di base delle pratiche di gestione della produzione è che la capacità produttiva di ogni stazione di lavoro è la stessa. Sappiamo però che anche in assenza di fluttuazioni statistiche potrebbe essere difficile ottenere un bilanciamento perfetto tra le diverse stazioni di lavoro. Inoltre nella realtà gli sbilanciamenti di capacità esistono e spesse volte sono anche molto pronunciati. Questi sbilanciamenti combinati con le fluttuazioni statistiche che si hanno in ogni processo fanno sì che nell'impianto si formino code di semilavorati, in genere di fronte alle macchine più lente. Uno degli assunti di base delle pratiche correnti è sostanzialmente infondato. La TOC fonda la sua capacità di individuare soluzioni breakthrough 8cioè soluzioni che facciano conseguire all’organizzazione che le adotta un drastico miglioramento delle sue performance) proprio nel sollevare sistematicamente gli assunti che stanno alla base dei comportamenti e nel chiedersi costantemente se hanno senso.


Inseriamo nello schema del nostro impianto pilota la capacità di ogni stazione di lavoro misurata in unità prodotte per giornata lavorativa (pezzi/giorno). 


E' ovvio che nelle realtà produttive le differenze di capacità non saranno così marcate, ma questa considerazione non va a inficiare la sostanza dei ragionamenti che ci apprestiamo a fare.


Nel nostro caso la macchina numero 4 è il constraint, infatti è ovvio vedere che è la macchina più lenta della catena e quindi quella che determina il tasso di produzione di prodotto finito e quindi, prescindendo da tutte le considerazioni sul mercato (ricordiamo che stiamo assumendo che il mercato assorba ogni prodotto che riusciamo a spedire), determina il risultato complessivo dell'impianto.


Ne consegue logicamente che quello che transita dal constraint dovrebbe essere allineato con la domanda del mercato e la schedulazione delle operazioni dovrebbe essere sincronizzata con le date di consegna richieste dai clienti. Questo fatto determina la schedulazione della macchina constraint, che in gergo TOC viene chiamato DRUM.


Il ROPE è la connessione tra il rilascio della materia prima e la schedulazione del drum.In poche parole il rilascio di nuova materia prima (alla prima stazione di lavoro) deve avvenire non appena il materiale è transitato per il constraint. In questo modo nell'impianto circola solo la quantità di materiale necessaria ad alimentare il constraint. Tutte le macchine non constraint devono solo processare il più velocemente possibile il materiale che si trovano "davanti", e in questo modo siamo sicuri di aver soddisfatto i requisiti complessivi della produzione: tempi di consegna, quantità domandata.


Il terzo ingrediente della ricetta DBR è il cosiddetto BUFFER. Il buffer in primo luogo è una quantità di tempo e non di materiale, come normalmente si è portati a ritenere. In sostanza il BUFFER è la quantità di tempo che intercorre tra il rilascio della materia prima alla stazione 1 e la data di consegna interna a valle della macchina constraint, determinata dalla schedulazione del DRUM. Nel nostro schema di impianto è la lunghezza della linea produttiva (in tempo) dalla macchina 4 al rilascio della materia prima.

Va poi considerato che essere capaci di garantire che il materiale raggiunga il constraint nel tempo stabilito non è sufficiente, se non si vende il prodotto finito non si otterranno utili, è necessario allora assicurarsi, al fine di ottenere un profitto, che il prodotto finito arrivi al cliente per tempo. C'è quindi un ulteriore elemento che deve essere determinato e cioè quanto tempo ci vuole per muovere il materiale dal constraint al mercato (possiamo dire che questo tempo è il vero time to market); questo tempo deve essere adeguatamente bufferizzato, e lo si fa con il cosiddetto shipping buffer.


In molti ambiti produttivi non è possibile identificare il constraint così facilmente come abbiamo visto sopra. E’ dunque necessario usare un approccio un po’ più raffinato, ma ugualmente efficace, disponendo all’inizio solo un buffer (shipping buffer), che viene calcolato sulla base delle date di consegna pattuite degli ordini dei clienti e del lead time complessivo della linea produttiva.


Una volta stabilito il buffer, attraverso la gestione di esso è possibile identificare il constraint interno e quindi schedulare la produzione in accordo con esso.


Questa appena vista è una breve descrizione del meccanismo fondamentale del DBR. Rimane un ultimo aspetto da affrontare, come far sì che i miglioramenti conseguiti con l’implementazione del DBR non rimangano statici, ma si inneschi un processo di miglioramento continuo. La risposta della TOC a questa istanza consiste nei 5 passi del processo di focalizzazione, aspetto che è alla base di ogni implementazione di drum buffer rope, insieme all’uso sistematico dei TP-tools (cioè agli strumenti di pensiero sistemico. Questi elementi forniscono il necessario grado di rigore scientifico all’analisi dei problemi e permettono di identificare i constraint non fisici, come ad esempio politiche o comportamenti. 

I 5 passi di focalizzazione sono i seguenti:


Passo 1 – identificare il/i constraint(s) del sistema


Identificare significa che si ha già un’idea di quale sia il fattore limitante le performance del sistema, la cosiddetta risorsa scarsa e si decide da quale partire; in questo passo non è importante avere una lista di constraint basata su qualche priorità, la lista dei candidati è molto molto breve, prima o poi dovremo confrontarci con tutti.

Ci vuole l’abilità di determinare attraverso l’osservazione e l’analisi dei dati (per una specifica introduzione alle tecniche di controllo statistico di processo si rimanda al documento di riferimento) la risorsa scarsa, che è il fattore limitante dell’impianto. Solo quando questa risorsa è stata identificata è possibile sviluppare una schedulazione basata sul DRUM. In gergo se la domanda del mercato è superiore alla capacità del constraint, questo viene anche chiamato bottleneck. Per poter schedulare il drum occorre conoscere il volume di prodotto richiesto giorno per giorno, e la distinta base di ogni prodotto.


Passo 2 – decidere come sfruttare il constraint


Poiché il constraint è il fattore che limita le performance non ci rimane che decidere come dobbiamo spremere dal constraint tutto quello che può dare. Sfruttare è quello che si deve fare, nulla di più nulla di meno. E se il constraint è esterno, cioè è il mercato – abbiamo abbastanza capacità ma non abbastanza ordini? Allora sfruttare significa fare tutte le consegne in tempo, non basta il 99%, ci vuole il 100%.


In ambito produttivo prima di fare qualsiasi altra cosa occorre spremere dal constraint ogni minuto di processo. Questo ha delle ovvie implicazioni sulle politiche di manutenzione, di ispezione qualità, ecc.


Cosa succede a tutti gli altri componenti il sistema?


Passo 3 – subordinare tutto il resto alla decisione presa al passo 2


Il ruolo di una risorsa non-constraint è assicurare che il constraint lavori nel modo migliore possibile in modo da massimizzare il throughput. Ciò significa che tutti i processi, le interdipendenze del sistema devono essere disegnati per ottimizzare il lavoro del constraint.


Se è il constraint che determina la capacità produttiva complessiva dell’impianto (e anche il profitto, purché siamo nelle condizioni che il mercato assorbe tutto quello che viene prodotto) nulla deve impedire a questa capacità di venire meno. Per esempio il rilascio della materia prima deve avvenire in accordo con la capacità della risorsa scarsa (constraint). Questo implica che nell’impianto gira solo quanto serve per alimentare il constraint (e quindi si riduce il wip al livello minimo per assicurare il massimo di profittabilità dell’impianto, scendere ancora di wip metterebbe a rischio la capacità produttiva del constraint e quindi metterebbe a rischio il profitto).


A questo punto siamo sulla strada giusta, ma non basta


Passo 4 – elevare il constraint


Elevare significa aumentare la capacità del constraint. Tutto quello che si poteva fare per ottimizzare il sistema è stato fatto, per incrementare il throughput è necessario elevare il constraint (che può voler dire più macchinari, più persone, ecc.).


Per rompere il constraint occorre aggiungere altre macchine o convertire le macchine presenti. E’ molto importante evitare che il constraint si sposti per effetto dell’aumento della capacità produttiva del constraint originale. Quindi l’azione di elevamento del constraint deve essere accompagnata da un’azione di elevamento della capacità degli elementi che alimentano il constraint stesso.


Passo 5 – Se nel passo precedente il constraint è stato rotto ritornare al passo 1


Questo passo è fondamentale per non farsi prendere dall’inerzia, Goldratt dice che se tu ti dimentichi del constraint esso non si dimentica mai di te!


Quando si tenta di mettere in pratica questo approccio, ci si trova di fronte un conflitto, quasi inevitabilmente. Le misure che comunemente vengono utilizzate dal management per valutare le prestazioni di un impianto fanno a pugni con la necessità di soddisfare i requisiti dei clienti. Il management trova molto difficile subordinare le azioni al conseguimento dell’obiettivo (cioè sul constraint), cercando di prestare uguale attenzione alle mille difficoltà e problemi che si presentano ogni giorno nell’impianto; l’assunto che sostiene che questo atteggiamento è esprimibile così: per ottenere l’ottimo globale occorre raggiungere tutta una serie di ottimi locali.

 MA QUESTA E' TUTTA UN'ALTRA STORIA, AL PROSSIMO EPISODIO


lunedì 6 ottobre 2014

La misura della complessità nella gestione dei rischi (industriali, finanziari, aziendali,….) Uno strumento di anticipazione di crisi e conflitti.


I sistemi complessi, quali una raffineria o una centrale nucleare o una rete di filiali bancarie, sono caratterizzati da un elevato rischio operativo e da una elevata complessità.
Elevato rischio operativo e elevata complessità che, per chi non ha mai dovuto affrontarli, sono assimilabili alla sensazione di essere in balia degli eventi che proviamo nell’era attuale della globalizzazione.

La nostra capacità individuale e collettiva di dominare questa crescente complessità non è sufficiente a farci dormire sonni tranquilli.

Viviamo in tempi turbolenti, dominati da incertezze, recessioni e mercati sempre più volatili. Queste ed altre manifestazioni della globalizzazione stanno contribuendo ad un aumento drammatico di complessità in tutte le sfere della vita sociale e, in maniera particolare nell’economia. Ma la globalizzazione è il risultato dell’aumento della complessità o è proprio l’aumento della complessità che da luogo alla globalizzazione?
La globalizzazione, dal nostro punto di vista, emerge spontaneamente quando un sistema socio-economico raggiunge un sufficiente grado di complessità. L’aumento globale della complessità – che è conseguenza di determinate leggi della fisica – è ciò che rende inevitabile la globalizzazione. Per gli stessi motivi, una società sufficientemente complessa produce, inevitabilmente, fenomeni come il terrorismo o l’emergenza di conflitti.

La nostra società globale è come una enorme e dinamica rete, composta da nodi e collegamenti. Il numero di collegamenti fra i nodi (individui, aziende, mercati, nazioni) stanno aumentando velocemente, così come il numero di nodi stessi. Analogamente a quanto accade nei sistemi industriali complessi.

Una caratteristica fondamentale di questa rete è la sua entropia, che ne quantifica l’incertezza. Poiché i nodi non si comportano sempre in un modo razionale e prevedibile, i collegamenti sono “sporchi”. Poiché globalmente la quantità di entropia può soltanto aumentare – conseguentemente alla Seconda Legge della Termodinamica - mentre nuovi collegamenti vengono creati, molti altri vengono distrutti. Questo processo è inevitabile. Infine, la rete è instabile, dinamica e stocastica e il suo sviluppo e la sua entropia stanno accelerando velocemente. A che conduce tutto ciò? Il nostro mondo diventerà sempre più più complesso, incerto e turbolento. L’unica costante è il cambiamento ed il tasso di crescita della complessità sta aumentando.

È quindi facilmente comprensibile quanto sia difficile ed arduo prendere le giuste decisioni in circostanze simili. Non c’è più tempo per cercare ed implementare soluzioni ottimali ai problemi che oltretutto sono intrinsecamente fragili e che sono più adatte a circostanze dominate da stati di determinismo. Ambienti instabili, incerti e in rapida evoluzione, richiedono decisioni veloci e robuste.

Oggi è possibile misurare la complessità di queste reti in una maniera razionale. È inoltre possibile misurare il tasso di aumento della complessità. Chiaramente, alta complessità implica un elevato sforzo di gestione.

Ecco perché, intuitivamente, gli esseri umani preferiscono star lontani da situazioni altamente complesse. La migliore tra le soluzioni funzionanti è quella più semplice.

Ma grazie allo studio della complessità siamo in grado di valutare quando le reti dinamiche cominceranno a sgretolarsi. Infatti, una data rete dinamica non può svilupparsi oltre il proprio limite “fisiologico” noto come complessità critica. Quando questo limite viene raggiunto, la rete diventa criticamente complessa e si comincia a comportare in maniera fragile diventando, quindi, vulnerabile. Quando una parte della rete globale “soffre” o si spezza, abbiamo una crisi.

L’alta densità dei collegamenti garantisce una veloce propagazione delle crisi e dei traumi nel resto della rete. Quindi un problema locale si trasforma rapidamente in un problema globale.

La crisi sub-prime degli Stati Uniti ne è un buon esempio. La crisi si è espansa rapidamente attraverso l’economia mondiale.

A causa della natura della rete e, per di più, a causa della relativa complessità che velocemente aumenta, simili crisi diventeranno sempre più frequenti in tutti I sistemi complessi.

Siccome queste crisi hanno un impatto non più locale ma globale sorge una domanda a cui dare una risposta: È possibile anticipare e quindi prevedere tali crisi? Può l’anticipazione di crisi trasformarsi in un nuovo paradigma di gestione e di management? La risposta è affermativa.

Oggi, grazie alla disponibilità di soluzioni innovative che consentono di misurare e di gestire la complessità, è possibile anticipare crisi e conflitti. La disponibilità di un efficace sistema di pre-allarme ha un valore economico e politico significativo.

Il concetto è semplice: lo stato di salute di un dato sistema è proporzionale alla differenza fra la sua complessità critica ed il valore attuale di complessità. In prossimità della soglia di criticità il sistema diventa fragile e quindi vulnerabile.

Il punto è, quindi, la capacità di poter misurare sia la complessità così come il corrispondente limite critico. Ontonix ha sviluppato delle misure “naturali” per entrambi, lavoriamo direttamente con i dati grezzi estraendo regole e relazioni tra i parametri utilizzando delle tecniche di trattamento d’immagine appositamente sviluppate.

Con queste premesse possiamo stabilire che un sistema entra in uno stato di pre-crisi quando si avvicina alla propria soglia di complessità critica. La misurazione dell’andamento della distanza di un sistema dalla relativa complessità critica fornisce direttamente una misura della sua vulnerabilità.

I sistemi che vengono mantenuti ad una distanza di sicurezza dalla criticità sono robusti e quindi godono di una bassa esposizione al rischio. Questa regola ha validità generale e si può applicare ad a impianti industriali complessi (centrali nucleari) così come a sistemi più ampi (settore immobiliare o il controllo del traffico aereo).

L’enorme valore di questa metodologia trova le sue radici in un fatto fondamentale: il crollo di sistemi sufficientemente complessi è spesso dovuto a cause endogene. Eventi traumatici provenienti dall’esterno (esogeni) non sono affatto necessari per distruggere un sistema molto complesso. E’ proprio l’elevata complessità che diventa causa primaria della loro naturale vulnerabilità. La storia è piena di esempi.

ma che cos'è la complessità?

La complessità è una naturale proprietà di ogni sistema. È definita come un mix di struttura (connettività) e incertezza. Così come per esempio l’energia, la complessità è una proprietà fondamentale ed intrinseca di tutti i sistemi dinamici quali l'economia, la società, l'Internet, l'ambiente, sistemi di traffico ecc. Le persone tentano istintivamente di stare lontani da situazioni di elevata complessità a causa di una ragione fondamentale: un’elevata complessità implica capacità di sorprendere.
  

'Complesso' non implica necessariamente 'complicato.' Un sistema estremamente complicato può possedere numerosi componenti (per esempio il meccanismo di un orologio) ma non essere in grado di comportarsi in una maniera inaspettata. D’altra parte, sistemi con pochissimi componenti possono essere estremamente difficili da gestire senza essere complicati.

Complessità è la misura della quantità di informazione strutturata presente in un sistema; ovvero un insieme di regole correlate tra di loro dinamiche e organizzate. Con regola intendiamo l’espressione SE A allora B.

La topologia delle interazioni tra le regole riflette la struttura dell’informazione che scorre in un dato sistema.

Alcuni fatti riguardanti la complessità:

Un sistema è tanto più funzionale quanto più è complesso, la capacità di un sistema di realizzare delle funzioni è proporzionale alla sua complessità
Ogni sistema può raggiungere un valore massimo di complessità, chiamata complessità critica.
Nelle vicinanze della complessità critica il sistema diventa fragile, non è consigliabile operare in prossimità di questa soglia
Alta complessità significa comunque difficoltà a gestire.
Quando un sistema è nelle vicinanze della complessità critica va ristrutturato, o va aggiunta nuova “struttura” o va semplificato
Più componenti non significano necessariamente più complessità, un sistema con pochi componenti può essere più complesso di un sistema con molti componenti


Perché gestire la complessità?

Ci sono due buone ragioni di misurare e gestire la complessità. Prima di tutto, le leggi della fisica assicurano che la crescita della complessità è inevitabile. Ma è anche vero che sistemi estremamente complessi sono difficili da capire e da controllare. Buoni esempi sono l'economia globale, i mercati finanziari o il clima. Sappiamo che un’elevata complessità implica capacità di sorprendere. L’attuale crisi economica è un buon esempio. La crescente complessità oggi è il nostro principale problema, quindi va gestita.

La seconda ragione sta nel fatto che la complessità non può crescere in maniera illimitata. Infatti, risulta che ogni sistema ha un proprio limite naturale della complessità noto come complessità critica. Quando la complessità di un sistema si avvicina a questa soglia, il sistema stesso diventa fragile, sviluppando comportamento caotico ed inaspettato. Questa soglia impone limitazioni fisiche allo sviluppo sostenibile. Perciò, è vitale per i manager conoscere la complessità della propria azienda, cosi come la corrispondente complessità critica. In un'economia turbolenta la gestione del rischio diventa gestione della complessità.


Che cosa accade in prossimità della complessità critica?

Quando un certo sistema dinamico si trova in prossimità della sua Complessità Critica il suo comportamento diventa imprevedibile. Questa è una proprietà dei sistemi molto complessi che intuitivamente cerchiamo di evitare ed è difficilmente comprensibile e gestibile. L’ammontare di complessità di un sistema è proporzionale allo sforzo che occorre fare per gestirlo. In prossimità della Complessità Critica il comportamento del sistema passa repentinamente da un modo all’altro. Questo spiega perché certi sistemi vanno in default senza un preallarme.

Spasmi o crisi in un sistema dinamico sono accompagnati da inaspettate variazioni della sua complessità. La magnitudine dello spasmo è misurata dal delta di complessità prima e dopo lo spasmo.

Quando si è nelle vicinanze della complessità critica si osservano alcuni fatti:

La maggior parte delle relazioni tra le variabili sono vicine alla saturazione, sono molto sfumate e a volte deboli. La trasmissione dell’informazione diventa inaffidabile

Un piccolo aumento dell’entropia può causare che queste relazioni svaniscano

In queste condizioni la gestione del sistema è altamente impredicibile (rischiosa)


Misurando la distanza tra la complessità critica e il valore corrente di complessità di un sistema è possibile misurarne in tempo  reale la sua stabilità con un apposito indice in grado di segnalare in anticipo spasmi o crisi del sistema.

Volete degli esempi, sul sito ne troverete a bizzeffe: www.ontonix.com

Come fare per spremere più valore dagli asset che un'organizzazione già possiede?


Volendo farla breve partiamo da una semplice affermazione, le cui implicazioni portano molto lontano.

Qualunque azienda può spremere più valore dagli asset che possiede se sa rispondere a 3 domande chiave:

  1. I nostri processi e il nostro sistema sono stabili e a variabilità ridotta?
  2. Sappiamo dove stanno i colli di bottiglia e li sappiamo gestire?
  3. Abbiamo un sistema di pre-allarme che ci avvisa quando la complessità sta raggiungendo la soglia critica e siamo a rischio collasso?
Sia ben chiaro, quello che vale per l’azienda vale altrettanto bene per qualsiasi sistema: un binomio cliente-fornitore, una intera supplì chain, una pubblica amministrazione, un ospedale e chi più ne ha più ne metta.

Una precisazione anche sul significato della parola asset. Non stiamo parlando solo delle cose fisiche e tangibili, ma anche e soprattutto delle persone, del loro potenziale inespresso.

Per rispondere a queste 3 domande vi servono 2 ingredienti:

Un brainware adeguato

L’oceano di dati messo a disposizione da un sistema informativo

Con la parola brainware intendiamo un insieme di metodi e tecniche che si fondano sul paradigma sistemico. Questo significa abbandonare il vecchio paradigma gerarchico- funzionale.

 
Le componenti principali del brainware sono 3, una per ciascuna domanda:

  1. I nostri processi e il nostro sistema sono stabili e a variabilità ridotta?

Ci affidiamo alla “teoria delle variazioni”, o meglio alla seconda componente del metodo Deming: Understand how variation impacts the system, e ai metodi e tecniche necessari per implementarla.

Qual è la ragione che ci spinge in questa direzione? La constatazione che i costi associati a un processo crescono quadraticamente con l’ampiezza del suo intervallo di variabilità.


  1. Sappiamo dove stanno i colli di bottiglia e li sappiamo gestire?

Ci affidiamo alla TOC – theory of constraints.

Qual è la ragione che ci spinge in questa direzione? La constatazione che: il throughput che la vostra azienda è in grado di generare mese dopo mese è DETERMINATO  unicamente dai vostri “colli di bottiglia”


La parola “throughpput” suscita sempre diffidenza, sia perché è inglese e ahimè intraducibile, sia perché è incomprensibile rimanendo all’interno del paradigma tradizionale non-sistemico. Throughput è la misura ultima del perché le persone che lavorano insieme in un’azienda si dannano l’anima per ottenere un buon risultato. Ha sicuramente una componente economica, ma ne ha anche una seconda, spesso più importante, non economica.

  1. Abbiamo un sistema di pre-allarme che ci avvisa quando la complessità sta raggiungendo la soglia critica e siamo a rischio collasso?

VIVIAMO IN UN MONDO ESPONENZIALE i nostri sforzi rischiano di essere compromessi da eventi ritenuti “trascurabili” e lontani da noi, come prevenirli?
Ci affidiamo alla Teoria della Complessità e alle tecnologie e metodologie necessarie per praticarla (www.ontonix.com)


mercoledì 6 agosto 2014

Un'analisi scientifica delle variazioni del PIL italiano


Analisi del PIL mediante analisi della sua variabilità (carta di comportamento di processo) , scopo determinare se sistema predicibile o meno.

Utilizzati dati istat da primo trimestre 2005 a primo trimestre 2014

Prima carta di comportamento di processo, utilizzati 12 trimestri per costruire limiti di oscillazione, equivalente a ipotizzare che sistema nel periodo 2005-2007 sia “stabile”

Sorpresona delle sorpresone il sistema è “instabile” già nel periodo 2005-2007!!!!


E dopo l’inizio ufficiale della crisi che cosa succede, ignoriamo i 4 trimestri del 2008 (a occhio nudo si nota che il processo è totalmente instabile) e ricalcoliamo i limiti usando i 12 trimestri 2009-2001 , ecco che cosa accade:


il sistema continua a essere instabile cioè non predicabile…..

riproviamo con analisi differenti:

limiti calcolati con 8 trimestri 2009-2010 – non cambia nulla, sistema instabile


limiti calcolati con 8 trimestri 2012-2013 – sistema instabile, non predicibile


Traiamo delle conclusioni scientifiche, tutto questo parlare di crisi, uscita dalla crisi, ripresa,  ricorda molto le discussioni sul moto dei gravi prima di newton, pura aria fritta, chiacchiere da bar.

P.S. la tecnologia qui utilizzata è stata messa a punto nel 1924, è di fatto free.

PP.SS. come si fa a modificare in meglio un sistema "instabile", basta leggere un buon libro (tratto da Fourth Generation Management di Brian Joiner):


La strategia delle cause speciali per migliorare sistemi instabili consiste nel:
·           Procurarsi dati tempestivi così che le cause speciali vengano segnalate velocemente: I dati tempestivi sono essenziali per un’azione efficace contro le cause speciali. Questo è vero sia che l’effetto sia negativo sia che sia positivo. Per ottenere dati velocemente potremmo utilizzare una cifra approssimativa che possiamo ricavare immediatamente - per esempio, sulla base di una proiezione delle valutazioni dei clienti – piuttosto che attendere giorni o settimane per un dato più accurato. Spesso è anche utile cercare dei modi per monitorare i fattori di processo che siano altamente correlati con i risultati del processo, come ad esempio partenze “in orario” come primo indicatore di processo della soddisfazione del cliente per i tempi di arrivo.
·           Mettere a punto un rimedio immediato per contenere qualsiasi danno: Questa fase è il Livello 1 di Attacco (p. 31), giocare a caccia alla talpa, spegnere il fuoco. Come riporteremo questo progetto in linea con la pianificazione? Che cosa faremo per questo cliente arrabbiato? Che cosa faremo riguardo al prodotto che abbiamo già spedito?
·           Cercare la causa – vedere cosa c’è stato di diverso: Cosa è successo, quando, dove, e con chi. Fate caso anche a ciò che non è avvenuto: Ci sono problemi correlati che vi sareste potuti aspettare di vedere ma non è successo? Quando non è successo? Dove non è successo? Quali lavoratori o gruppi non hanno avuto il problema? Cercate le cause profonde. Continuate a chiedervi “perché, perché, perché” fino a che non trovate la causa più profonda sulla quale potete incidere.
·           Sviluppare un rimedio a più lungo termine: Abbiamo imparato qualcosa di molto utile. Ora che la fonte della causa speciale è stata identificata, siamo in una posizione molto migliore per sviluppare una soluzione a lungo termine che ne possa prevenire il ripetersi, o, se i risultati sono buoni, preservare e mantenere il beneficio. Generalmente, questo significa modificare qualche sistema a un livello più alto.


domenica 3 agosto 2014

Gestione per processi verso il miglioramento continuo

Anche questo è un pezzo, scritto 15 anni fa alla vigilia del più importante cambiamento, finora, introdotto nella iso 9001, il passaggio allo schema sistemico o per processi.

Fu un percorso travagliato che seguimmo in presa diretta nella speranza, poi delusa, che lo standard inglobassero perlomeno facesse esplicito riferimento alle metodologie più adeguate a supportare un'organizzazione genuinamente per processi.


La nuova versione dello standard per i sistemi di qualità ISO9001:2000 sottolinea ulteriormente l’importanza di elementi quali la sincronizzazione delle risorse, il focus sul cliente, l’utilizzo di tecniche statistiche di analisi e misure, la definizione di autorità e responsabilità, ecc… per una gestione efficace dei processi in ottica di miglioramento continuo.
Le differenze introdotte impongono una serie di cambiamenti che prefigurano un comportamento aziendale diverso da quello tradizionale. Il modo in cui si pensa l’azienda influisce profondamente sul modo in cui la si gestisce. L’attuale versione delle norme ISO ha consentito alle aziende di pensarsi in termini di “flusso di processi” nella costruzione di un sistema qualità, ma di rappresentarsi (e quindi gestirsi) con il tradizionale organigramma.
La necessità che ha dato origine in passato a questa rappresentazione è quella sacrosanta di mantenere il controllo della situazione in ogni istante sapendo “chi riporta a chi”. Con il passare del tempo, tuttavia, si è sentita sempre più forte la necessità per le organizzazioni di far fronte alla crescente complessità delle operazioni e delle interazioni tra le diverse funzioni.
In questa condizione lo schema di tipo gerarchico - funzionale si è rivelato del tutto inadeguato dal momento che in esso non sono esplicitati tre fattori fondamentali:
1)    il cliente
2)    le interazioni trasversali tra le funzioni
3)    un meccanismo di feedback da parte del mercato
Questi elementi sono alla base di un modello di gestione per processi, che vede nella gestione delle interdipendenze il modo più efficace per rispondere alle richieste sempre crescenti del mercato in ottica di miglioramento continuo.

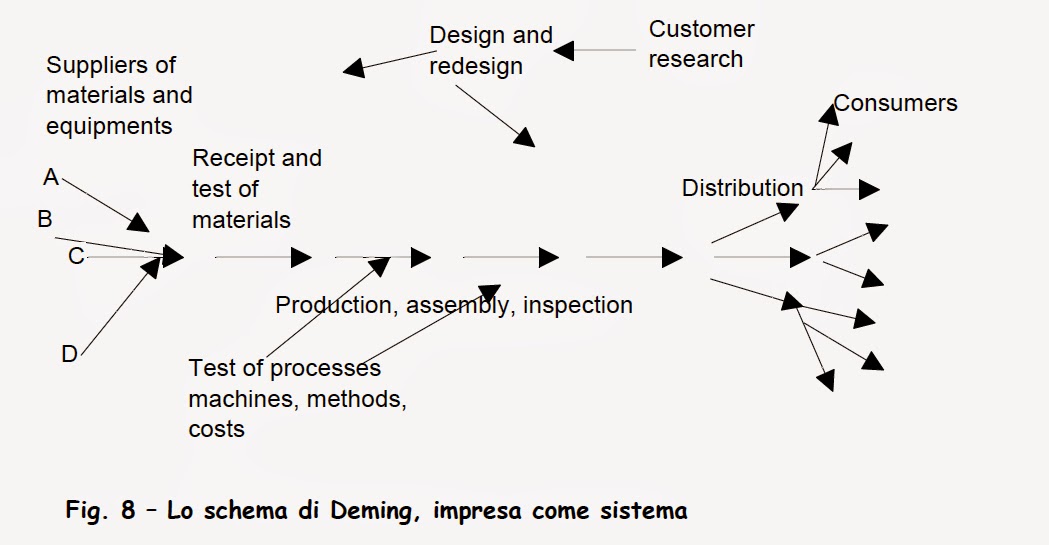
L’impresa come sistema

La gestione per processi, dunque, parte da una visione dell’azienda come sistema, ovvero come un insieme di processi che lavorano insieme per il raggiungimento di un obiettivo comune e condiviso.
La definizione della rete di interdipendenze tra i processi costitutivi del sistema, è il primo passo verso la loro gestione, che prevede la comprensione del loro comportamento attraverso lo studio della variabilità da cui sono affetti. Mi spiego, un processo genera nel tempo un risultato che oscilla attorno ad un valore medio. L’analisi della variabilità con cui i dati vengono generati, ovvero della loro dispersione attorno al valore medio fornisce informazioni sul comportamento futuro del processo.
Lo strumento che permette di monitorare e continuamente migliorare lo stato di un processo è la carta di controllo di Shewart. Questa, infatti, permette di visualizzare oltre al comportamento dei processi nel tempo anche il tipo di variabilità da cui essi sono affetti.
Se la variabilità esiste per tutti i processi, infatti, per alcuni è controllata e per altri è incontrollata.  Soltanto i processi affetti da variabilità controllata, detti anche stabili, mostrano predicibilità, e di conseguenza sono gestibili.  Processi instabili non danno alcuna garanzia sul loro comportamento futuro, rendendo così vano qualsiasi sforzo verso il miglioramento degli stessi.

La stabilizzazione dei processi

La stabilizzazione dei processi è il prerequisito per la loro gestione.
Oltre alla carta di controllo, altri strumenti a supporto di questa fase di stabilizzazione sono gli strumenti logici forniti dalla TOC ( Theory of Constraints), sviluppata dal fisico israeliano Eli Goldratt negli ultimi 20 anni. In particolare la “Nuvola di Disallineamento” e “l’Albero della Transizione”, aiutano a definire le basi su cui costruire un processo di miglioramento continuo delle prestazioni. L’utilizzo di questi due strumenti consente di definire i ruoli delle persone all’interno dell’organizzazione eliminando ogni disallineamento tra autorità e responsabilità e fornendo un meccanismo di trasmissione di istruzioni chiare. La “Nuvola di Disallineamento”, infatti, aiuta a focalizzare sul problema, molto sentito nelle organizzazioni, per cui spesso le persone si trovano ad avere la responsabilità e la competenza per svolgere un’attività, ma sono bloccate nel loro lavoro da altre che ne hanno l’autorità formale.
“ L’Albero della Transizione” fornisce un meccanismo fondato sulla logica causa effetto per definire procedure di lavoro e trasferire istruzioni chiare a tutti i livelli.
Queste due azioni: riallineare autorità e responsabilità e ridisegnare le procedure, trovano generalmente molte resistenze. La motivazione risiede nel fatto che ad ogni procedura definita sarà associato un sistema di misura per la valutazione del lavoro delle persone. E’ logico, quindi, che le persone si comportino in modo da massimizzare il risultato delle prestazioni secondo il sistema di misura adottato.
Qualsiasi cambiamento del modo di concepire e definire i ruoli, le procedure e le istruzioni di lavoro dovrà essere seguito da un sistema di misura della prestazioni coerente.
Se il lavoro delle persone dev’essere in linea con l’obiettivo, e se il sistema di misura delle prestazioni spinge le persone a comportarsi in modo coerente con esso, ci si chiede quale debba essere l’obiettivo del sistema e quali unità di misura debbano essere adottate per quantificare l’impatto che ogni singola azione ha su di esso.

Il controllo del sistema

Tornando al problema iniziale, chi gestisce un’organizzazione ha la necessità di esercitare controllo su di essa. Che cosa si intende per controllo?

Probabilmente la possibilità di monitorare ed intervenire sulle prestazioni del settore di organizzazione di cui si è responsabili.
Tuttavia non accade mai che un intervento riguardi una sola area funzionale. Certamente non possiamo affermare che la produzione sia la sola responsabile di ciò che accade esclusivamente in produzione, la produzione è un elemento della catena e la sua prestazione è fortemente influenzata da tutte le altre aree funzionali. Aree funzionali che hanno ragione di esistere poiché in esse sono contenute le necessarie competenze.
Il limite di una struttura gerarchico funzionale, infatti non è la presenza di aree funzionali, bensì il modo in cui esse vengono controllate, con l’idea che sia la somma degli ottimi locali a fare l’ottimo globale.
Di fatto, la forte interdipendenza tra le funzioni richiesta dalla complessità intrinseca del lavoro di oggi rende illusoria l’idea di poter controllare l’operato di ogni singola funzione.
Guardando il sistema globale su che cosa dobbiamo concentrare l’attenzione per esercitare controllo?
 Secondo la TOC, ogni organizzazione ha un vincolo, ovvero un elemento che ne limita le prestazioni verso l’obiettivo prefissato. I risultati ottenuti da un organizzazione i cui processi mostrano una ragionevole prevedibilità dipendono dal suo vincolo; è su questo, quindi, che ci si deve concentrare per massimizzare le prestazioni.
Il controllo del vincolo permette di controllare la prestazione dell’intero sistema e, contemporaneamente, di visualizzare le interdipendenze tra i processi soddisfando così entrambe le necessità sottese ad una buona gestione.

La gestione del sistema

Gestire il sistema, quindi, significa gestire il vincolo. Goldratt propone cinque passi, I cinque passi di focalizzazione, per gestire il vincolo di un organizzazione in ottica di miglioramento continuo delle prestazioni:
1.    Identificare il vincolo
2.    Sfruttare il vincolo
3.    subordinare il sistema al vincolo
4.    elevare il vincolo
5.    se il vincolo è stato eliminato tornare al passo 1, evitando che l’inerzia diventi il vincolo

Il vincolo può essere di tipo fisico, tipicamente in produzione una macchina o un gruppo di macchine; identificarlo è relativamente semplice, probabilmente è quella fase di produzione davanti alla quale si accumulano i semilavorati.
Nella gestione di un progetto, il vincolo è individuato dalla catena critica, ovvero dalla catena più lunga di attività dipendenti che tiene conto della contesa di risorse, ed è generalmente rappresentato dalla scarsa disponibilità di una o più risorse.
Più in generale possiamo identificare il vincolo analizzando la variabilità associata ai processi ed al loro modo di interagire.
Se le prestazioni globali del sistema dipendono dalle prestazioni del vincolo, allora è necessario proteggerlo per assicurarsi che esso non smetta mai di produrre.
Il meccanismo di protezione del vincolo è il buffer, ovvero un ideale contenitore la cui unità di misura è il tempo. (in produzione il buffer ad esempio è una quantità di tempo in anticipo sul rilascio del materiale che assicuri sempre lavoro al vincolo; nella gestione dei progetti il buffer è la quantità di tempo che si accumula alla fine del progetto prima della data di consegna prefissata)
Il controllo sulle prestazioni del sistema viene esercitato mediante un continuo monitoraggio della quantità di buffer consumato. Immaginando il buffer come un contenitore ideale, le azioni sul sistema saranno dettate dal suo livello di svuotamento.
In quest’ottica quello che è stato introdotto come un meccanismo di controllo delle prestazioni diventa un efficace e rigoroso strumento strategico per chi gestisce l’organizzazione. 

L’implementazione di un modello sistemico

La gestione per processi in ottica di miglioramento continuo, come richiesto dallo standard, presuppone la creazione delle condizioni per il miglioramento continuo del fattore limitante l’organizzazione.
Quali sono le difficoltà legate all’implementazione di un modello di gestione per processi?
La risposta ci riporta al conflitto di fondo di tutte le organizzazioni: adottare uno schema di gestione gerarchico funzionale vs. adottare uno schema non gerarchico – funzionale.
All’interno di una struttura organizzativa di tipo gerarchico le persone sono portate a sviluppare una visione molto ristretta del modo in cui lavora l’organizzazione di cui fanno parte. Se oltre a questo si aggiunge un sistema di misura delle prestazioni che premia gli ottimi locali, diventa impossibile che le risorse indirizzino i propri sforzi verso un’ottimizzazione globale.
Per costruire un approccio di gestione realmente sistemico è necessario rivalutare la struttura di governo di un’organizzazione.

Conclusione 

Lo standard rappresenta una linea guida per i responsabili della qualità, ma non fornisce un modello e gli strumenti necessari per la soddisfazione dei requisiti richiesti.
In conclusione un modello di gestione sistemica rappresenta la direzione della soluzione ai problemi di chi deve certificarsi e di chi deve adattare il proprio sistema di qualità alla nuova release dello standard.
Identificata la direzione della soluzione, si definiranno le azioni da intraprendere per soddisfare i requisiti del sistema di qualità richiesti da Vision 2000. Il Decalogo, metodica di gestione sistemica realizzata negli ultimi due anni, fornisce il metodo e gli strumenti per l’implementazione dei requisiti richiesti unendo alla realizzazione di un sistema di qualità coerente ed efficace ( strutturazione dei processi, analisi e misure dei processi, definizione dei ruoli in azienda, costruzione della documentazione, …), gli aspetti produttivi da considerare per garantire la crescita in ottica di miglioramento continuo delle prestazioni.